클로드 소넷 5.5 무료로 쓸 수 있나? 구독료와 API 비용 차이
Anthropic은 Claude Sonnet 5.5 출시를 발표했고 한국을 Claude 지원 국가로 명시한다. 다만 공개 자료만으로 무료 계정의 모델별 배정·한도를 확정할 수 없다. 토큰당 API 가격은 이전 모델과 같으며 “최대 30% 저렴”은 회사 자체 시험의 작업당 비용이다. 독립 시험은 설정에 따라 비용이 높아질 수도 있음을 보여준다.
2026년 9월 28일, Anthropic이 Claude Sonnet 5.5를 공개했다. 회사는 이전 Sonnet 5보다 결과를 30% 이상 빠르게 만들고, 대부분의 작업에서 처리 비용을 최대 30% 낮췄다고 설명한다. 하지만 이 문장을 “Pro 구독료가 30% 내려간다”로 읽으면 곤란하다. API의 토큰당 가격은 Sonnet 5와 같고, 한 작업의 비용은 모델이 실제로 몇 토큰을 쓰느냐에 따라 달라진다. 독립 평가에서는 가장 높은 추론 설정에서 오히려 Sonnet 5보다 작업당 비용이 높게 나왔다.
한국은 Claude 서비스 지원 국가다. 다만 공개된 Anthropic 자료만으로는 한국의 모든 무료 계정에서 Sonnet 5.5를 직접 선택할 수 있는지, 무료·Pro별 정확한 사용량이 얼마인지 확인되지 않는다. 아래에서는 공식 출시 발표, 회사가 제시한 자체 시험, 독립 시험, 편집팀의 활용 의견을 구분해 설명한다. Anthropic의 Sonnet 5.5 발표와 지원 국가 목록을 2026년 9월 29일 확인했다. PUNIFIX는 Sonnet 5.5를 직접 사용해 성능을 비교하지 않았다.
먼저 답하면: 한국은 지원 국가지만 무료 계정의 모델 선택 범위는 미확인
확인된 사실: Anthropic의 지원 국가 목록에는 South Korea가 Claude 서비스와 API의 지원 지역으로 나온다. Anthropic은 Sonnet 5.5를 여러 플랫폼에서 제공한다고 발표했고, 웹·데스크톱에서 한국어를 사용하는 것도 공식 지원 언어 목록에 포함돼 있다. 따라서 한국에서 Claude를 이용할 수 있다는 점은 확인된다. 다만 “한국 이용자가 모두 같은 시점에, 같은 요금제와 모델 선택 메뉴로 Sonnet 5.5를 본다”는 뜻은 아니다. 지원 국가 목록, 한국어 사용 안내, 모델 출시 발표
무료·Pro의 미확인 범위: Sonnet 5.5 출시 글은 모델의 플랫폼 가용성을 설명하지만 Free와 Pro 각각에서 모델 선택 메뉴가 어떻게 보이는지, 계정별 배포 시점과 정확한 한도가 얼마인지 표로 안내하지 않는다. Claude의 요금제 페이지는 Free가 무료이고 Pro가 더 많은 사용량과 더 많은 모델 접근을 제공한다고 설명하지만, 공개 페이지에서 Sonnet 5.5의 요금제별 세부 배정은 확인되지 않는다. 그러므로 “무료에서 무제한으로 쓸 수 있다”거나 “Pro에 가입해야만 쓸 수 있다”고 단정할 근거도 없다. Claude 요금제·사용량 안내
계정이 있다면 실제 모델 선택 메뉴와 사용량 화면에서 Sonnet 5.5가 표시되는지 확인하는 것이 가장 정확하다. 보이지 않는 경우에도 한국 지원 여부와 모델별 배포 여부는 별개의 문제일 수 있다. 구독 결정을 먼저 내리기보다 본인 계정에 표시된 모델과 결제 금액을 확인하자.
Sonnet 5.5는 무엇이 달라졌나
Anthropic은 Sonnet 5.5를 복잡하고 판단이 오래 필요한 작업을 맡는 Opus 5.5와, 빠른 대량 작업을 맡는 Haiku 계열 사이에서 일상 업무를 처리할 중간 모델로 소개한다. 회사가 제안한 대표 작업은 범위가 분명한 버그 수정, 문서·슬라이드·스프레드시트 작성과 다듬기다. 특히 이전 모델보다 빠르게 초안을 만들고, 짧은 피드백을 받아 반복 수정하는 작업을 겨냥한다. 이는 Anthropic의 제품 포지셔닝이지, 모든 사용자의 업무에서 확인된 성능 보증은 아니다. Anthropic 출시 발표
변화의 핵심은 세 가지다.
모바일에서는 표를 좌우로 밀어 전체 내용을 볼 수 있습니다.
| 달라진 점 | 발표에서 확인한 내용 | 읽을 때 주의할 점 |
|---|---|---|
| 속도 | Anthropic은 Sonnet 5보다 출력 생성이 30% 이상 빠르다고 발표 | 작업 전체가 항상 그만큼 빨라진다는 뜻은 아님 |
| 토큰 단가 | 입력 100만 토큰당 $2, 출력 100만 토큰당 $10으로 Sonnet 5와 동일 | API 목록 가격 자체가 내려간 것은 아님 |
| 작업당 비용 | Anthropic은 자체 시험에서 대부분의 작업 비용을 최대 30% 낮췄다고 발표 | 시험 과제·추론 설정·토큰 사용량에 따라 개인 결과는 다를 수 있음 |
회사는 지식 작업 평가인 GDPval-AA v2.1에서 Sonnet 5.5가 1,844점을 기록해 Sonnet 5의 1,449점보다 높았고, Opus 5.5의 1,846점과 비슷했다고 공개했다. 코드 작업의 Terminal-Bench 4.0에서는 Sonnet 5.5가 70.6%, Sonnet 5가 10.3%였다고 제시했다. 이 수치는 Anthropic이 공개한 평가 결과다. 점수는 정해진 테스트 과제의 결과이며, 한국어 보고서 작성이나 개인의 실제 문서·코드에서 같은 차이가 난다는 뜻은 아니다. Anthropic의 평가표와 방법 설명
공식 비교 시연: 새떼를 움직이는 HTML을 한 파일로 만들기
Anthropic의 출시 페이지에는 Sonnet 5와 Sonnet 5.5에 같은 요청을 주고 결과를 나란히 보여주는 비교 시연이 있다. 첫 번째 요청은 “HTML 파일 하나로 400마리 찌르레기의 군무를 만들라”는 내용이다. 모래 언덕을 바람으로 움직이게 하거나, 작은 시계 24개로 큰 시계를 만드는 예시도 이어진다. 문서를 요약하는 데서 끝나지 않고 결과물을 코드로 만든 뒤 화면에 띄우는 작업을 보여준다는 점에서, 새 모델의 반복 제작·수정 능력을 설명하려는 자료다. Anthropic 공식 비교 시연
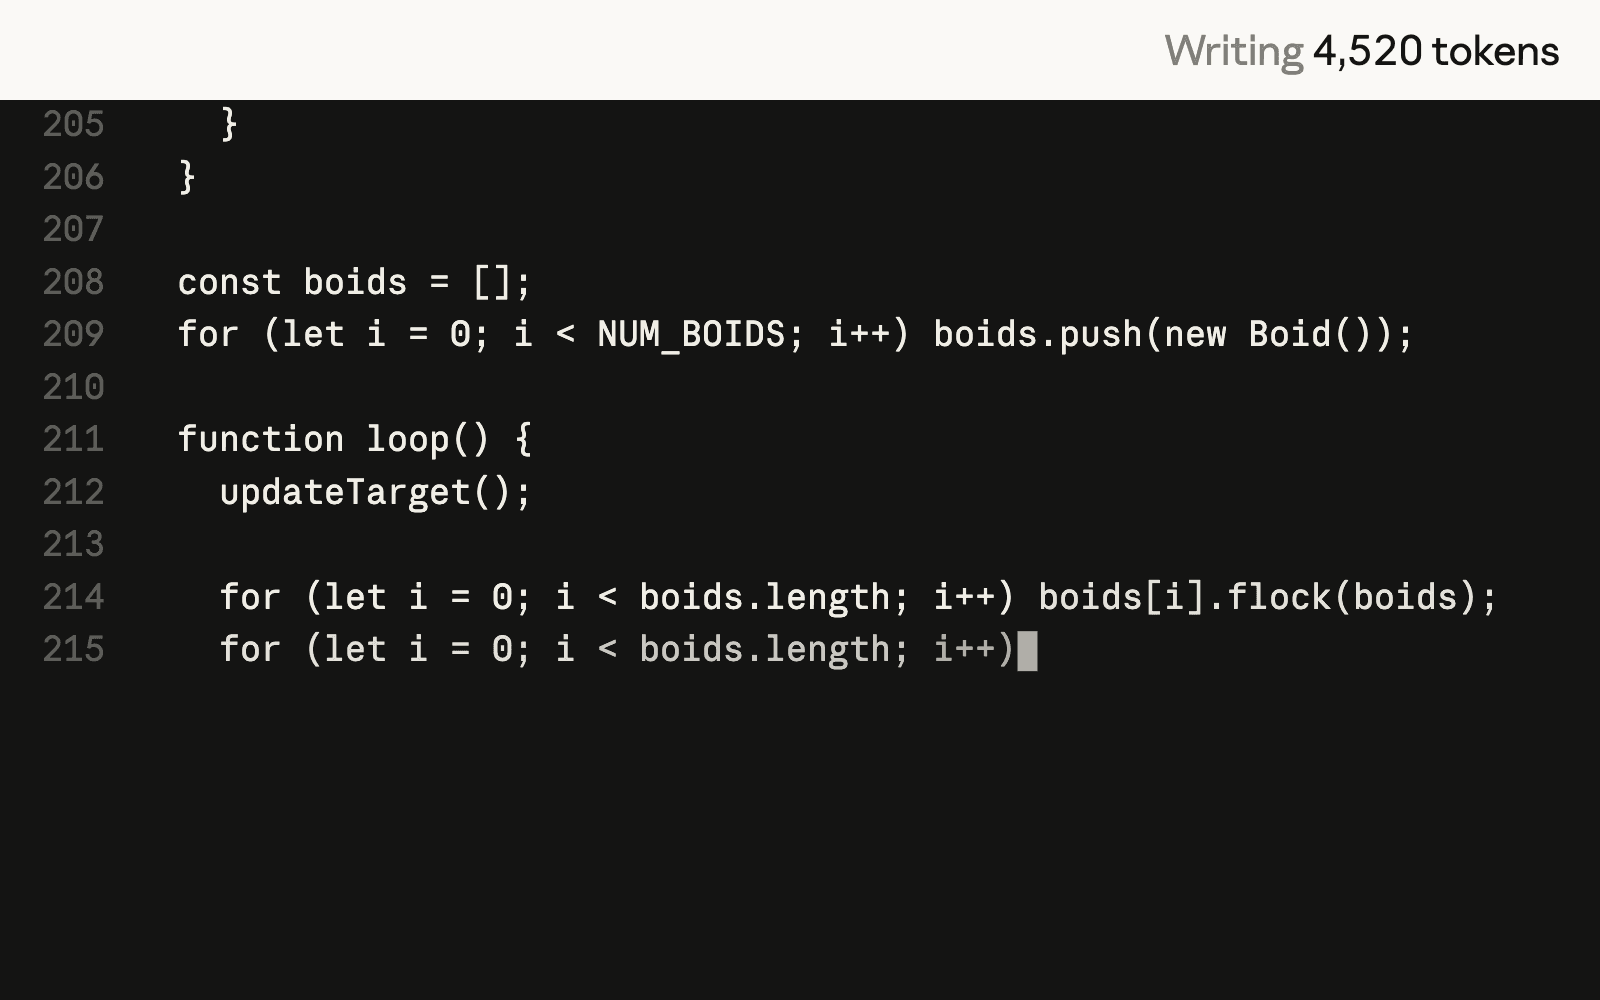
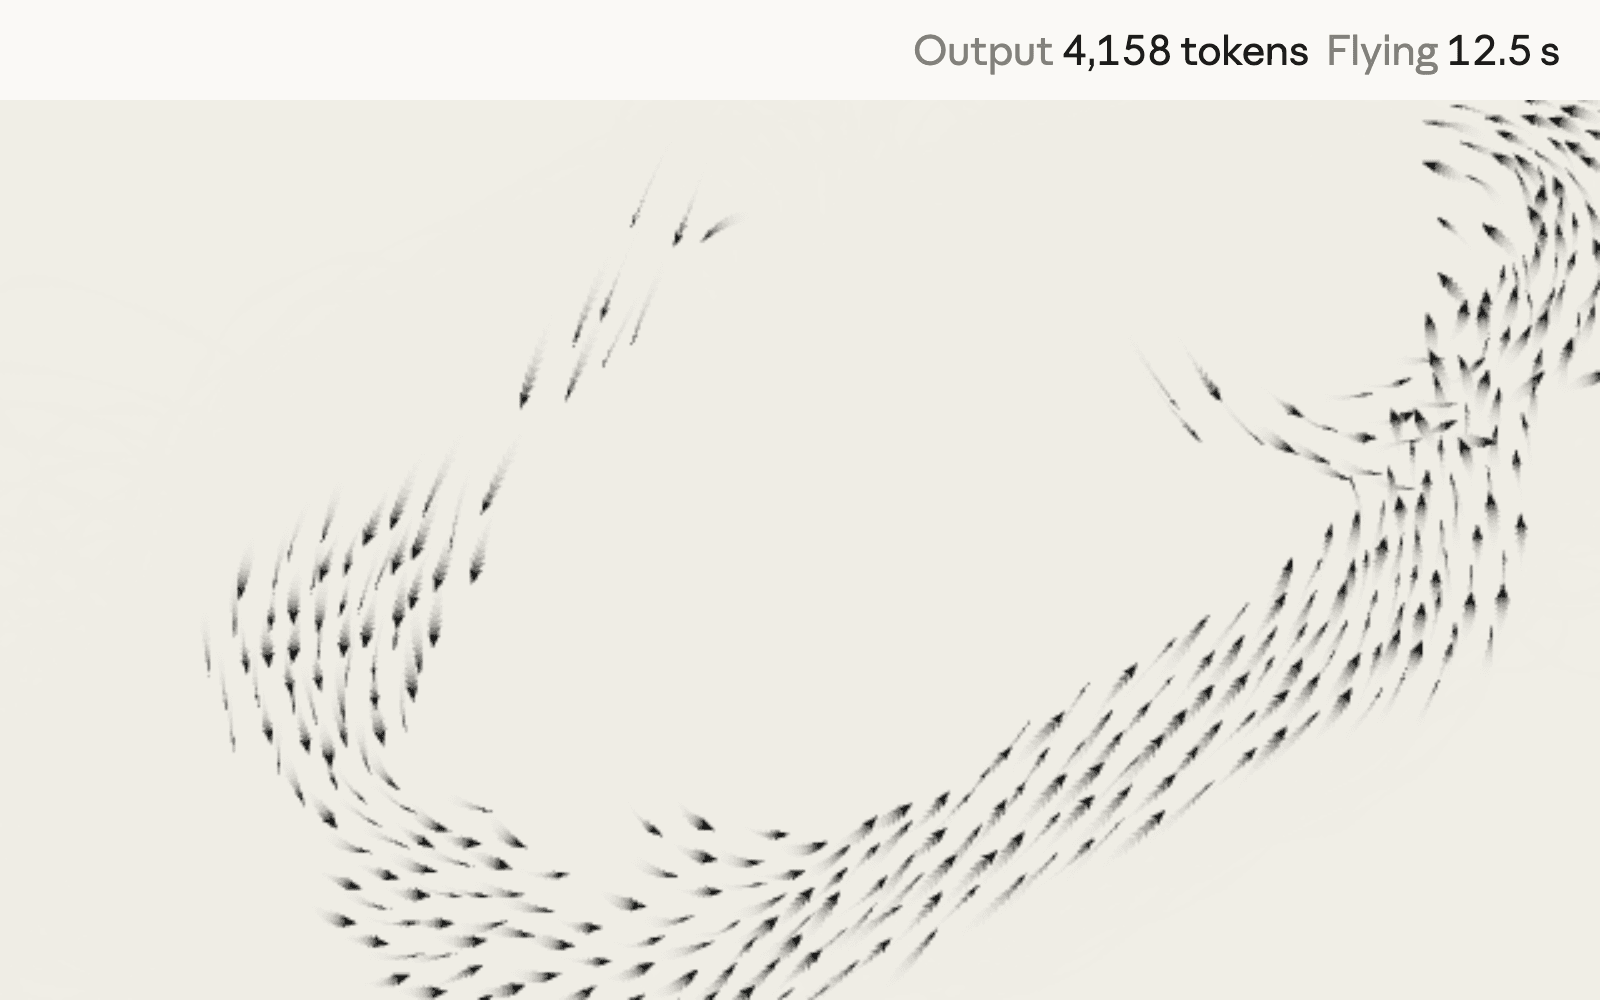
이 화면은 Anthropic이 만든 공식 데모다. 독립 기관의 대조 실험도 아니고 PUNIFIX가 같은 요청을 직접 재현한 결과도 아니다. 따라서 “Sonnet 5.5가 언제나 더 보기 좋은 웹 결과물을 만든다”고 확대 해석할 수는 없다. 이 비교 화면은 회사가 선택한 시연 장면이므로 결과의 모양과 출력량을 읽는 참고 자료로만 보아야 한다.
실제 업무 사례와 일반 이용자가 적용해볼 만한 일
회사가 소개한 업무 사례
Anthropic의 발표에는 여러 협력사가 진행한 평가가 소개돼 있다. 예를 들어 Box는 문서 안의 데이터를 다시 확인해 이전 모델이 놓친 오류를 발견했다고 보고했고, Zendesk는 고객 지원 사례 처리 시간이 더 빨랐다고 밝혔다. Unity는 자체 편집기·코딩 과제에서 작업 결과를 다시 열어 실행해 보고, 다단계 과제의 90%를 완료했다고 설명했다. 모두 실제 기업이 자사 환경에서 시험했다고 소개한 사례지만, 시험 설계와 결과를 제공한 주체가 기업 또는 Anthropic이라는 점을 함께 봐야 한다. 일반 이용자가 같은 수준의 결과를 보장받는다는 독립 검증은 아니다. 기업 사례와 평가 조건은 Anthropic 발표
독립 코드 리뷰 시험은 비용과 속도에서 개선을 관찰
코드 리뷰 서비스 업체 CodeRabbit은 자기네 리뷰 파이프라인으로 Sonnet 5.5와 Sonnet 5를 비교했다. 13개 실제 오픈소스 변경 건의 작은 묶음에서는 확인된 문제를 Sonnet 5.5가 6개, Sonnet 5가 4개 찾아냈고, 실행 가능한 지적의 정밀도는 각각 41.2%와 40.0%였다. 별도로 85개 알려진 문제를 포함한 44개 오픈소스 PR에서 평균 리뷰 시간은 Sonnet 5.5가 6분 33초, Sonnet 5가 13분 31초였다. CodeRabbit은 이 44건에서는 Sonnet 5.5가 PR당 모델 호출에 약 $0.46, Sonnet 5는 약 $1.16을 썼다고 계산했다. CodeRabbit의 시험 보고서
이 결과는 “코드 리뷰”라는 특정 업무와 CodeRabbit의 설정·파이프라인에 한정된다. 13건은 표본이 작고, 44건 시험에서는 보고서 작성 시점에 판정자의 정답 점수 산출이 끝나지 않았다고 업체가 밝혔다. CodeRabbit은 코드 리뷰 제품을 만드는 사업자라는 이해관계도 있다. 유용한 독립 관찰이지만, 일반 문서·한국어 글쓰기·무료 플랜의 체감 성능으로 바꿔 말할 수는 없다.
편집팀이 제안하는 시험 방법
일반 이용자가 결과를 살펴보고 싶다면 새 결제부터 하기보다 이미 자주 하는 일을 하나 고르고, 결과 조건을 구체적으로 적어 비교하는 편이 낫다. 예를 들어 회의 메모를 붙여넣고 “결정 사항·담당자·기한을 표로 나누고, 근거가 없는 항목은 빈칸으로 남겨줘”라고 요청할 수 있다. 초안 편집이라면 “뜻은 보존하고 반복 문장만 줄이며, 바꾼 문장 뒤에 이유를 표시해줘”처럼 범위를 정한다. 스프레드시트 분석에서는 “계산식과 가정을 따로 쓰고, 자료에 없는 원인은 추측하지 말아줘”라고 덧붙일 수 있다.
이런 요청은 PUNIFIX가 권하는 비교 방법이지 Sonnet 5.5를 실제로 시험해 얻은 결과가 아니다. 같은 자료·같은 지시를 기존 모델에도 주고, 사실 오류·빠진 항목·수정 횟수·완료까지 걸린 시간을 직접 비교하면 자신에게 필요한 차이를 판단하기 쉽다. 모델이 “완료했다”고 말해도 문서의 수치나 코드 실행 결과를 직접 확인하는 절차는 남겨둬야 한다.
‘최대 30% 저렴’과 실제 작업 비용은 왜 다를까
가격을 볼 때 앱 구독료, API 단가, 한 작업에 청구되는 비용을 나눠야 한다.
- Claude 앱 구독료: Claude 웹·앱을 정액제로 쓰는 요금이다. 현재 공식 요금표는 미국 기준 Free $0, Pro 월 결제 $20, 연간 선결제 $200(월 환산 $17)을 안내한다. 국가·통화·세금에 따라 최종 금액이 다를 수 있으므로 한국 계정의 실제 금액은 결제 화면에서 확인해야 한다. 공식 요금표
- API 토큰 단가: Anthropic Claude Platform의 표준 API 요금은 입력 100만 토큰당 $2, 출력 100만 토큰당 $10이다. 캐시 읽기는 $0.20, 캐시 쓰기는 $2.50/100만 토큰이다. 예를 들어 캐시 없이 입력 10만 토큰과 출력 1만 토큰을 쓴다고 가정하면 입력은 $0.20, 출력은 $0.10, 합계는 $0.30이다. 단가를 이해시키기 위한 계산 예시이며 실제 사용량이나 청구 내역은 아니다. Claude Platform 가격표
- 작업당 비용: 한 요청을 끝내기까지 쓴 입력·출력 토큰과 반복 호출을 합한 비용이다. 똑같은 단가라도 모델이 적은 토큰으로 끝내면 총액이 줄고, 더 오래 생각하거나 여러 번 도구를 쓰면 늘 수 있다.
Anthropic의 “작업 비용 최대 30% 절감”은 세 번째 값을 자체 시험에서 비교한 회사 주장이다. 두 번째 API 단가가 내려갔다는 뜻이 아니며, 첫 번째 Pro 구독료가 할인됐다는 뜻도 아니다. 미국 기준 Pro는 같은 월 구독료를 안내하고 있고, Pro 구독에는 Claude Console API 이용료가 포함되지 않는다. API를 쓰려면 별도 Console 결제가 필요하다. Anthropic 발표, Pro와 API 결제 구분 안내
독립 평가가 보여준 비용의 반대편
독립 평가기관 Artificial Analysis는 Sonnet 5.5를 가장 높은 Max 추론 설정에서 시험했다. 이 평가에서 모델은 Intelligence Index 56점을 얻어 Opus 5.5의 58점에 가까웠지만, 평가 과제 한 건마다 약 19만 3천 개의 출력 토큰을 사용했고 작업당 비용은 $7.60이었다. 기관은 이를 Sonnet 5의 Max 설정보다 약 50% 높은 작업당 비용으로 계산했다. Artificial Analysis의 독립 평가
단, Artificial Analysis는 정식 공개 전 모델을 평가했고, 그 버전에는 구조화된 출력 요청에서 성능을 떨어뜨릴 수 있는 버그가 있었다고 보고했다. Anthropic이 공개 출시 버전에서 이를 수정했다고 전달받아 관련 평가를 다시 하겠다고도 밝혔다. 또 여기서 본 비용은 최고 추론 설정으로 정해진 인덱스 과제를 처리한 결과다. 평소 Claude 앱에서 짧은 질문을 주고받는 비용으로 환산할 수 없다.
VentureBeat의 출시 보도도 가격 단가 자체가 낮아진 것이 아니라, 토큰을 덜 쓰거나 도구 호출을 줄여 한 작업 비용을 낮춘다는 Anthropic의 설명을 짚었다. 매체는 “30%”를 계산한 방법을 Anthropic에 문의했지만 기사 작성 시점에는 답변이 없다고 밝혔다. VentureBeat 보도
두 시험은 같은 조건에서 서로를 반박하는 결과가 아니다. CodeRabbit은 반복 코드 리뷰에서 Sonnet 5.5가 Sonnet 5보다 토큰과 시간을 덜 썼고, Artificial Analysis는 최대 추론을 쓰는 별도 평가에서 출력 토큰이 크게 늘었다고 관찰했다. 작업 종류와 설정이 달라지면 작업당 비용도 달라질 수 있다는 해석이 가장 안전하다. Anthropic의 “최대 30% 절감”을 모든 개인 작업에 적용되는 할인율로 읽을 수 없는 이유다.
한국 이용자는 어디서 어떻게 확인하면 될까
Anthropic은 South Korea를 Claude와 API 지원 국가 목록에 포함한다. Claude 웹·데스크톱에서 한국어를 사용할 수 있다는 안내도 있다. 다만 지원 국가 목록은 지역 접근 가능성을 말해줄 뿐, 특정 계정의 요금제별 모델 선택 메뉴나 한국 원화 청구액까지 보증하지 않는다. Anthropic 지원 국가, 한국어 설정 안내
무료로 먼저 확인하려는 사람은 Claude에 로그인해 새 대화의 모델 메뉴와 사용량 표시를 살펴보면 된다. Pro를 고려한다면 현재 한국 계정의 월·연 결제 금액, 포함된 세금, 사용량 제한을 구매 직전 화면에서 확인하자. API 이용자는 본인의 Console에서 실제 입력·출력·캐시 토큰이 어느 정도였는지 확인한 뒤 계산해야 한다. 현재 공개 자료로 한국 계정의 원화 구독료나 Sonnet 5.5의 무료 계정별 고정 메시지 수를 대신 제시할 수는 없다.
API를 직접 연결하는 개발자는 모델 이름만 바꾸기 전에 공식 마이그레이션 안내를 보는 편이 좋다. Anthropic 문서는 Sonnet 5.5에서 기본 사고 설정과 강제 도구 선택 등 일부 API 동작이 달라질 수 있다고 안내한다. Sonnet 5.5 마이그레이션 안내
편집자의 판단: ‘무료냐’보다 먼저 볼 세 가지
Sonnet 5.5는 Sonnet 5와 같은 API 단가에서 속도·토큰 효율을 개선하려는 업데이트다. 회사 평가표와 일부 외부 실험은 개선 가능성을 보여주지만, 최고 추론 설정에서는 비용이 더 나올 수도 있다. “30% 싸졌으니 누구나 이득”이라는 문장으로 정리하기에는 사용 방식의 차이가 크다.
- 가끔 질문하는 개인 이용자라면: 계정에서 모델을 직접 선택할 수 있는지, 무료 사용량 안에서 얼마나 쓸 수 있는지 먼저 확인한다. 공개 자료만으로 모든 Free 계정 접근을 보장할 수는 없다.
- Pro 이용자라면: 모델의 API 단가보다 요금제 화면에 표시된 실제 사용량과 한도를 본다. Pro는 정액제 앱 이용이고 API 요금은 별도다.
- API 개발자라면: 모델 가격표만 보지 말고 자신의 입력·출력 토큰, 캐시와 추론 설정을 포함한 작업당 비용을 재계산한다. 최대 추론 설정은 토큰을 더 쓸 수 있다.
여기까지가 지금 확인할 수 있는 범위다. 한국 서비스 접근, 출시일, API 단가는 공식 자료로 확인했다. 무료·Pro 요금제별 모델 배정과 한국 계정 결제액은 계정별 결제 화면에서 확인해야 한다. PUNIFIX는 Sonnet 5.5를 직접 사용하거나 한국 계정에서 모델 선택 메뉴를 확인하지 않았으며, 다른 모델과 동일 조건으로 비교했다고 주장하지 않는다.
자료: Anthropic 공식 발표 · Claude 공식 요금표 · Anthropic 지원 국가 · Artificial Analysis 독립 평가 · CodeRabbit 자체 시험 · VentureBeat 보도
Anthropic 공식 출시·요금·지원 국가 자료, Artificial Analysis 독립 평가 및 CodeRabbit 자체 실험을 대조했습니다. 무료 플랜의 정확한 모델 버전/한도와 한국 계정 직접 이용은 미확인입니다.